Les miracles numériques du Coran résistent-ils au comptage ?
Des comptes annoncés à l'unité près, quatre décisions que personne ne prend avant de compter, et ce que la même méthode trouve dans Guerre et Paix
0. Le chiffre qui ferme la discussion
L’affirmation arrive souvent en fin de conversation, et elle a la forme d’une preuve. Le mot « jour » apparaîtrait dans le Coran exactement trois cent soixante-cinq fois, le mot « mois » exactement douze fois, et les mots « mer » et « terre » se répartiraient selon la proportion des surfaces du globe. Avez-vous déjà recompté l’un de ces chiffres ? Chacun de ces énoncés se présente comme vérifiable par n’importe qui, chacun se donne pour une simple observation, et aucun des convives n’a jamais refait le compte lui-même.
Ces affirmations circulent aussi sous des formes savantes, avec un appareil de références et des tableaux. En 2017, dans le Journal of Arts and Humanities, Al-Faqih propose une théorie fondée sur le nombre attribué à chaque lettre de l’alphabet, relie les statistiques du texte au nombre d’or et annonce des correspondances à l’unité près (Al-Faqih 2017). L’article existe. Il porte un identifiant permanent, il se cite et il se télécharge. La forme académique laisse intacte la question posée ici, qui vient avant et qui porte sur autre chose.
Cette question tient en une phrase, et elle est plus simple que tout ce qu’on pourrait lui opposer. Un compte de mots dans un texte ancien n’est pas une donnée brute, et il dépend de choix de méthode qui doivent être fixés avant que le comptage commence. Tant que ces choix restent ouverts, un total ne mesure pas le texte. Il mesure la décision de celui qui compte. Voilà pourquoi recompter derrière quelqu’un ne mène nulle part (le second compte sera contesté comme le premier).
Entrer dans la querelle du comptage reviendrait à en accepter la prémisse, qui est qu’il existerait un compte unique dont on pourrait ensuite discuter le total.
Ce qui est examiné ici est une famille d’arguments produits par des gens d’aujourd’hui, jamais le texte sur lequel ces arguments portent, et jamais ce que quiconque en croit. Un lecteur qui tient ce livre pour sacré peut suivre ce qui vient en gardant tout ce qu’il croit, et sans y trouver la moindre moquerie.
Ces comptes appartiennent à ce que la tradition nomme l’i’jaz, l’inimitabilité du Coran, dans son acception factuelle : une revendication sur des propriétés mesurables du texte. Le papier sur la douleur de quitter sa religion établit cette acception et ce que l’analyse statistique d’un style permet d’en dire ; le papier sur les arguments pour l’islam traite l’autre, esthétique.
L’argument développé ici accorde à chaque auteur une parfaite bonne foi, et il fonctionne avec elle. C’est ce qui le rend intéressant. Un argument qui aurait besoin de supposer la mauvaise foi de l’adversaire établirait peu de chose. En pratique, les auteurs discutés plus loin exposent leurs choix, et certains les défendent explicitement contre d’autres choix possibles.
1. Quatre choses à décider avant d’ouvrir le livre
Compter les occurrences d’un mot suppose quatre décisions préalables, et aucune ne va de soi. Ces décisions portent sur la version du texte qu’on ouvre, sur l’orthographe qu’on retient, ce qu’on accepte d’appeler un mot, et jusqu’où s’étend le texte qu’on accepte de compter. Ces quatre questions ont des réponses documentées. Elles se discutent dans des revues, et le bon sens n’y suffit pas. Chacune, prise séparément, suffit à faire varier un total sans que personne ait écrit quoi que ce soit de faux (et sans qu’aucun désaccord soit visible).
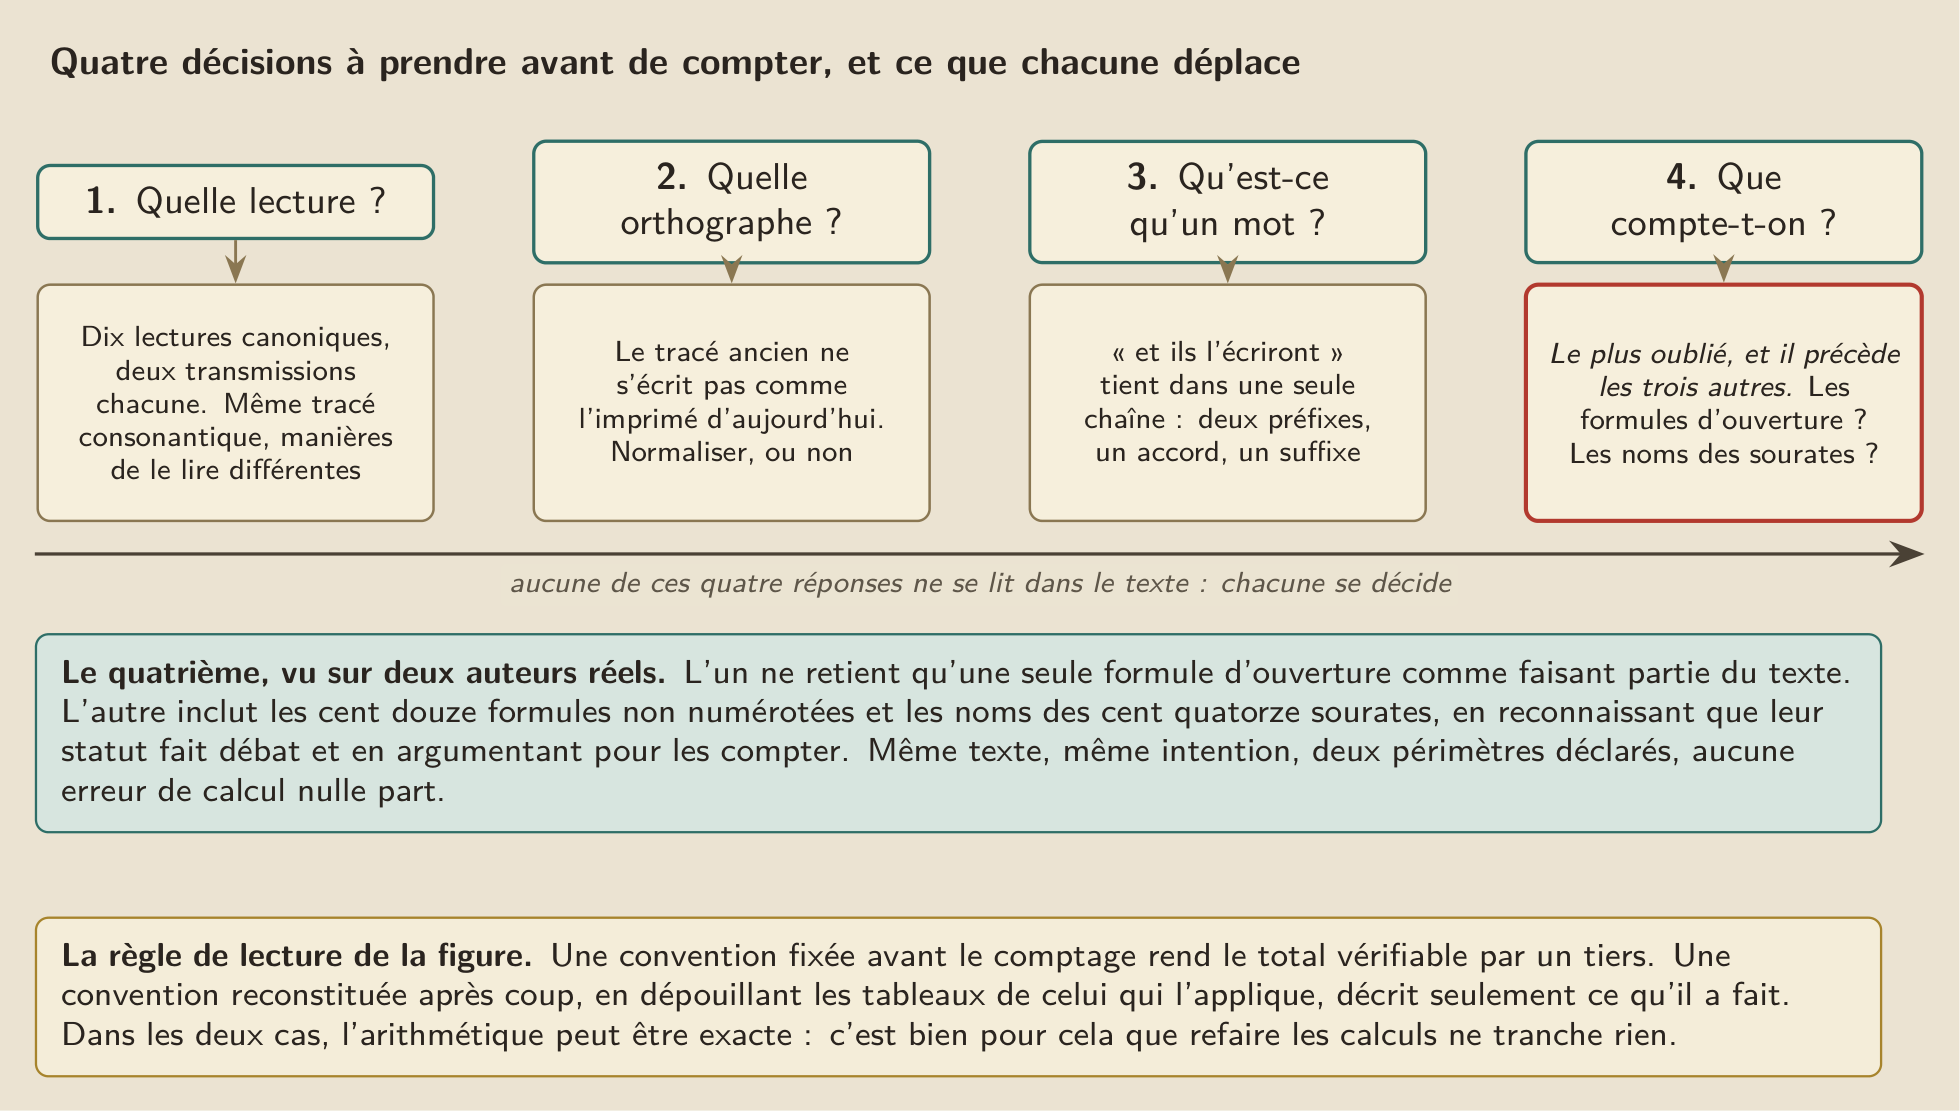
La première décision porte sur la lecture retenue. Le Coran se récite aujourd’hui selon dix traditions de lecture canoniques, chacune transmise par deux voies distinctes, et ces traditions se différencient par leur phonologie, par leur morphologie et par la manière dont elles interprètent un tracé ambigu (Melchert 2000; Nasser 2020; Putten 2022a, 2022b, 2022c). Elles partagent en revanche le même squelette consonantique, et cette unité est voulue.
Elle est une norme, et c’est le point qui décide de tout le reste. Van Putten rappelle en 2022, dans Dead Sea Discoveries, que l’accord avec le tracé consonantique figure parmi les trois conditions qui rendent une lecture valide, aux côtés de la correction grammaticale et d’une chaîne de transmission saine (Melchert 2000; Nasser 2020; Putten 2022a, 2022b, 2022c). Des lectures ont été écartées pour ne pas s’y conformer. La condition mordait donc. Une lecture qui aurait modifié le tracé serait restée hors du canon.
Cette exigence de conformité resserre le premier degré de liberté au lieu de l’élargir. Changer de lecture laisse intactes les consonnes écrites, ce qui écarte d’emblée l’image d’un texte flottant que personne n’aurait fixé. Ce qui change est la manière de lire ce tracé, et cela suffit à déplacer un compte, puisque l’écriture ancienne ne note pas les points qui distinguent certaines consonnes les unes des autres (Melchert 2000; Nasser 2020; Putten 2022a, 2022b, 2022c).
Le même travail signale que les lecteurs s’écartent parfois du tracé, en de rares occasions, et il en donne les raisons une à une (Melchert 2000; Nasser 2020; Putten 2022a, 2022b, 2022c). Trois raisons, en tout. Un problème de grammaire perçu par le lecteur, un autre codex régional portant une forme différente, un conflit avec les règles qui gouvernent la pause en fin de phrase. Des traditions restées hors du canon, transmises pourtant à travers les siècles, s’en éloignent plus librement dans le détail. La règle est donc réelle, et ses exceptions sont connues, comptées et discutées (ce qui est le contraire d’un flou).
La deuxième décision porte sur l’orthographe. Le texte consonantique ancien s’écrit autrement que le texte imprimé d’aujourd’hui, et les manuscrits les plus anciens en portent la trace visible. Van Putten a montré en 2019, dans le Bulletin of the School of Oriental and African Studies, que tous les manuscrits anciens partagent des particularités orthographiques identiques, ce qui indique un archétype écrit commun (Putten 2019; Déroche 2014; Dutton 2004). Ces particularités sont le genre de détail qu’un traitement automatique compte comme deux formes différentes.
Cette question pèse sur un total plus qu’on ne le croit. Une même forme écrite de deux manières selon l’époque produit deux entrées dans une table de fréquences, ou une seule, selon qu’on normalise ou non avant de compter (Putten 2019; Déroche 2014; Dutton 2004). Normaliser est une décision ; ne pas normaliser en est une autre. Les deux se défendent. Et le total change, parfois de plusieurs dizaines d’occurrences pour un seul mot.
La troisième décision est la plus lourde, et elle est purement linguistique. En arabe, l’article, les prépositions, les conjonctions et les suffixes se rattachent au radical à l’intérieur de la même chaîne écrite. Un exemple donné par les linguistes qui construisent les outils d’analyse le montre mieux qu’une explication : la forme qui signifie « et ils l’écriront » porte deux préfixes clitiques, une marque d’accord discontinue et un suffixe d’objet, le tout dans une seule chaîne (Habash et Rambow 2005; Pasha et al. 2014).
Combien de mots cette chaîne contient-elle ? La réponse dépend de la convention retenue, et les deux conventions existent chez les spécialistes. Pasha et ses coauteurs ont publié en 2014 un système dont une des tâches déclarées est justement la segmentation en unités, à côté de l’analyse morphologique et de la levée d’ambiguïté (Habash et Rambow 2005; Pasha et al. 2014). Que ce découpage soit un problème ouvert, traité par des systèmes dédiés et évalué comme tel, se lit dans toute la littérature du domaine.
Un facteur aggrave la difficulté, et il tient au système d’écriture lui-même. Les signes qui notent les voyelles sont facultatifs, si bien qu’une même chaîne de consonnes admet deux analyses grammaticales ou davantage, chacune donnant un découpage différent (Habash et Rambow 2005; Pasha et al. 2014). Lever cette ambiguïté demande un modèle. Le modèle a des paramètres, et les paramètres sont des choix. Un compte automatique hérite donc de toutes ces décisions sans que son résultat les affiche.
La quatrième décision est la plus facile à oublier, parce qu’elle précède les trois autres. Le périmètre du texte à compter se choisit, et cette frontière ne se lit nulle part. Les formules d’ouverture des sourates en font-elles partie ? Les noms des sourates, qui figurent dans les éditions imprimées, comptent-ils comme du texte ? Selon la réponse, des centaines de mots entrent dans le total ou en sortent, avant même qu’on ait ouvert une page.
Ces quatre décisions se prennent toutes sans qu’une réponse correcte puisse être opposée aux autres, et c’est ce qui change la nature du débat. Compter les formules d’ouverture est légitime. S’en abstenir l’est tout autant, et le désaccord porte sur une convention plutôt que sur un fait. Cependant, une convention n’a de valeur démonstrative qu’à une condition, celle d’avoir été fixée avant qu’on sache ce qu’elle produit.
Cette condition gouverne des domaines entiers. Un essai clinique enregistre son protocole avant de recueillir la moindre donnée, précisément pour que le choix des critères ne puisse pas suivre les résultats. Le principe est le même ici, sans l’appareil : dire d’avance ce qu’on compte et comment, puis compter, puis publier le total quel qu’il soit. À ce titre, un compte dont la règle se découvre après coup ne dit rien du texte.
Ces quatre décisions sont indépendantes les unes des autres, et elles se combinent en se multipliant. Un compte annoncé sans qu’aucune n’ait été fixée ne constitue pas un résultat contestable dont on discuterait le total, puisqu’on ignore ce qu’il mesure. Le lecteur qui entend un chiffre à l’unité près tient désormais quatre questions à poser, et elles se posent toutes avant la moindre discussion sur le chiffre.
2. La même recherche, dans un roman russe
Une affirmation numérique qui fixe sa méthode après avoir compté reste ajustable après coup, et donc invérifiable. Cette phrase paraît abstraite, et elle a pourtant été mise à l’épreuve dans une revue de statistique, sur un cas voisin, avec un résultat qu’on peut examiner point par point.
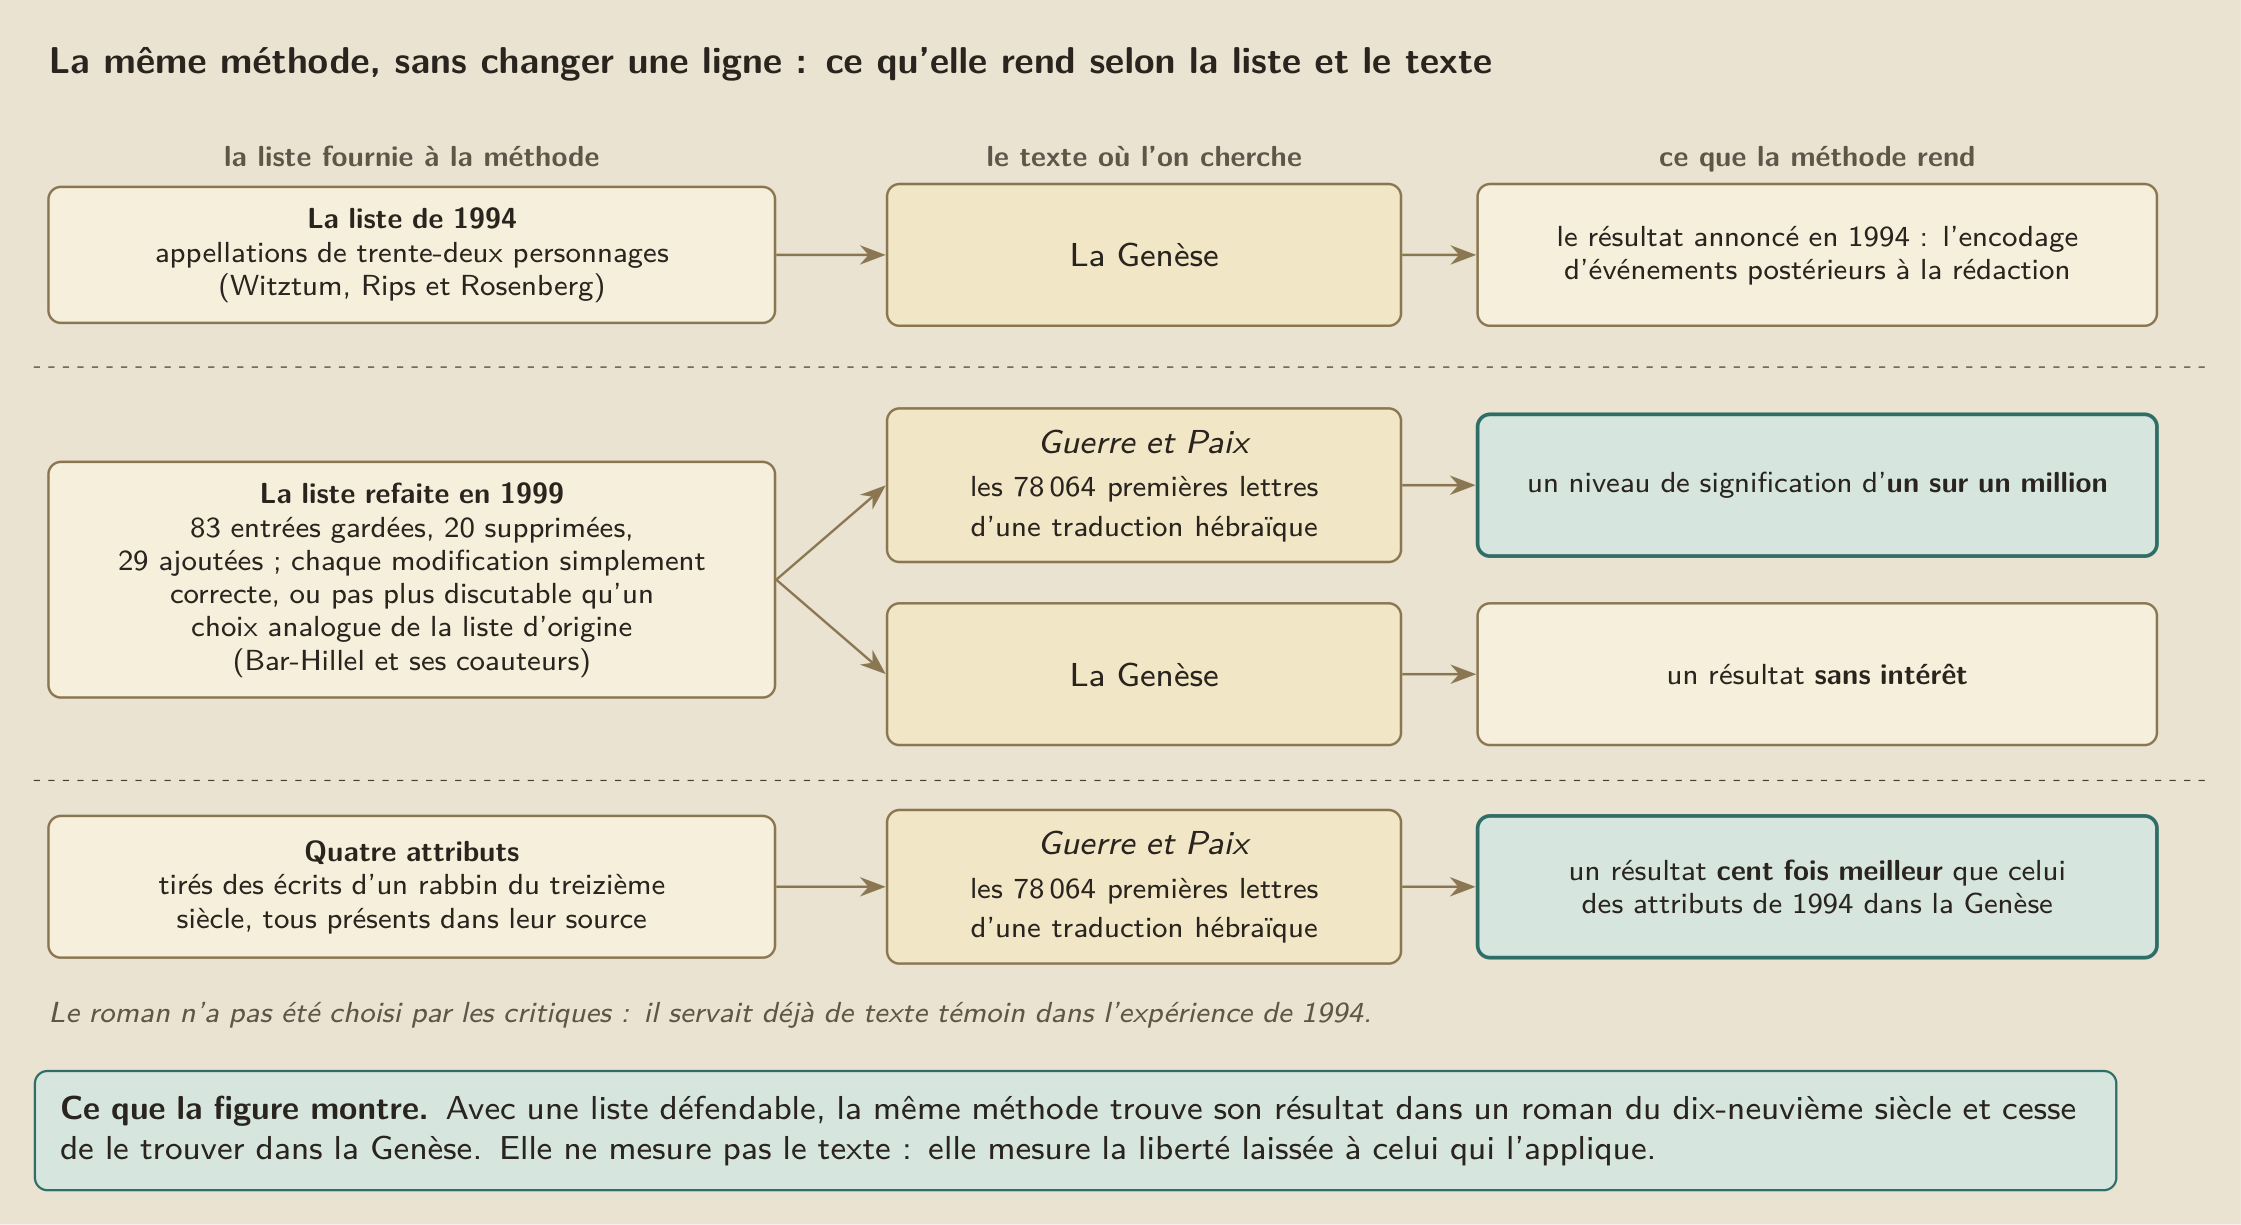
En 1994, Statistical Science publie un article de Witztum, Rips et Rosenberg consacré aux suites de lettres équidistantes dans le livre de la Genèse, qui affirme y trouver l’encodage d’événements postérieurs de siècles à la rédaction du texte (Witztum et al. 1994; Bar-Hillel et al. 1999). Cinq ans plus tard, la même revue publie la réponse. Bar-Hillel et ses coauteurs y soutiennent que le résultat de 1994 reflète les choix faits en concevant l’expérience et en rassemblant les données, plutôt qu’une propriété du texte étudié (Witztum et al. 1994; Bar-Hillel et al. 1999).
Ce qui emporte la conviction est une expérience refaite. Les auteurs de 1999 reprennent la liste des appellations des trente-deux personnages sur laquelle portait la seconde expérience, en gardant quatre-vingt-trois entrées, en supprimant vingt et en ajoutant vingt-neuf, chaque modification étant soit simplement correcte, soit pas plus discutable qu’un choix analogue de la liste d’origine (Witztum et al. 1994; Bar-Hillel et al. 1999). Ils appliquent ensuite la méthode initiale, sans y changer une ligne (c’est la condition pour que la comparaison signifie quelque chose).
Cette liste produit un niveau de signification d’un sur un million dans les soixante-dix-huit mille soixante-quatre premières lettres d’une traduction hébraïque de Guerre et Paix, et un résultat sans intérêt dans la Genèse (Witztum et al. 1994; Bar-Hillel et al. 1999). La méthode censée révéler une propriété du texte sacré la révèle dans un roman du dix-neuvième siècle, et cesse de la révéler là où elle avait été annoncée.
Le roman de Tolstoï n’a pas été choisi par les critiques pour les besoins de leur démonstration : c’est celui qui servait déjà de témoin dans l’expérience de 1994 (Witztum et al. 1994; Bar-Hillel et al. 1999). Le terrain de contrôle vient donc de l’expérience d’origine, ce qui retire à la réfutation le reproche qu’on lui adresserait d’abord, celui d’avoir choisi un terrain favorable.
Les mêmes auteurs rapportent une seconde expérience, plus parlante encore pour notre sujet. Un jeu de quatre attributs tirés des écrits d’un rabbin du treizième siècle produit, dans le roman et par la même méthode d’analyse, un résultat cent fois meilleur que celui obtenu dans la Genèse par les attributs de 1994 (Benjamini et Yekutieli 2001; Bar-Hillel et al. 1999). Ces quatre attributs figurent tous dans leur source (le reproche adressé à d’autres listes), ce qui écarte par avance le soupçon d’une fabrication commode.
Pourquoi la méthode trouve-t-elle toujours quelque chose ? La réponse tient à un fait ordinaire de la statistique, qui porte un nom et se traite avec des outils connus. Quand le nombre de comparaisons possibles devient très grand, des correspondances frappantes apparaissent sans qu’aucune cause les produise (c’est une propriété du grand nombre, pas du texte), et le contrôle du taux de fausses découvertes dans les tests multiples est la branche qui s’en occupe (Benjamini et Yekutieli 2001; Bar-Hillel et al. 1999). Un texte long autorise un nombre de comparaisons dont l’ordre de grandeur dépasse l’intuition (chaque pas d’espacement, dans chaque direction, sur chaque point de départ).
Ce mécanisme n’accuse personne d’avoir truqué les correspondances trouvées. Il dit que leur existence était attendue, et que le mécanisme suffit à l’expliquer. Une méthode qui trouve son résultat aussi bien dans Tolstoï que dans la Genèse mesure la liberté laissée à celui qui l’applique, plutôt que le texte. Le papier sur les arguments pour l’islam relève la même propriété chez le concordisme scientifique : la méthode « marche » sur n’importe quel texte.
Un lecteur attentif objectera que la démonstration de 1999 a elle-même exigé des choix, et il aura raison. Refaire une liste d’appellations suppose de décider quelles entrées gardent, lesquelles partent, lesquelles s’ajoutent, ce qui est la liberté dénoncée. Toutefois, c’est précisément ce qui fait la force de l’argument plutôt que sa faiblesse. Les auteurs ne prétendent pas avoir trouvé la bonne liste. Ils montrent qu’une liste défendable, construite avec le même degré de rigueur, renverse le résultat.
Cette manière de réfuter sert au-delà de Khalifa. Elle ne consiste pas à chercher l’erreur dans le travail adverse, exercice stérile quand les calculs sont justes. Elle consiste à appliquer la méthode annoncée à un cas où le résultat est connu d’avance, puis à regarder ce qu’elle rend. En d’autres termes, on teste l’instrument sur un objet dont on sait déjà ce qu’il vaut, ce qui est la manière ordinaire d’étalonner un instrument.
3. Le cas du dix-neuf, et sa suite inattendue
Le plus célèbre de ces arguments a une paternité, une date et une bibliographie, ce qui le rend examinable. La bibliographie de Moradi et Alizadeh Baygi mentionne l’ouvrage de Rashad Khalifa publié en 1982, consacré à ce qu’il présente comme une structure mathématique du Coran (Moradi et Alizadeh Baygi 2023; Khalifa 1982). Le nombre exact d’exemples contenus dans cet ouvrage reste à vérifier dans le texte primaire.
Ces affirmations ont été évaluées une à une, ce qui est rare et précieux. Moradi et Alizadeh Baygi ont publié en 2023, dans le Journal of Interdisciplinary Qur’anic Studies, une évaluation des cinquante-deux affirmations, menée du double point de vue de l’exactitude des calculs et des conditions requises pour parler de structure numérique (Moradi et Alizadeh Baygi 2023). Leur résultat est plus intéressant que ce qu’on attendrait, et il donne raison à la thèse défendue ici par un chemin inattendu.
Première surprise : Moradi et Alizadeh Baygi notent que la majorité des affirmations qu’ils examinent ne présentent pas de difficulté d’exactitude numérique (Moradi et Alizadeh Baygi 2023). Les calculs sont justes pour la plupart, et la question se joue ailleurs : des opérations exactes ne suffisent pas à établir une structure indépendante des choix de l’évaluateur.
La seconde surprise touche au cœur du sujet. Les critères de comptage employés par Khalifa ne figurent pas dans son livre sous forme de règles déclarées : ils ont dû être reconstitués par les évaluateurs, en dépouillant l’ensemble de ses tableaux pour retrouver les conventions qui rendaient ses totaux cohérents (Moradi et Alizadeh Baygi 2023; Khalifa 1982). Une certaine lettre longue n’est pas comptée, un signe de redoublement ne vaut pas deux lettres, et une seule des formules d’ouverture est tenue pour faire partie du texte (celle qui ouvre la première sourate) (Moradi et Alizadeh Baygi 2023).
Reconstituer une méthode à partir de ses résultats est l’inverse de la fixer avant de compter. Ces conventions sont défendables une à une. Le problème est qu’elles n’ont jamais été énoncées comme des règles opposables, applicables ensuite par un tiers à d’autres passages pour voir ce qu’elles donnent. Une règle qu’on découvre seulement en examinant les tableaux de celui qui l’applique se réduit à la description de ce qu’il a fait.
La composition même de l’ensemble éclaire la manière dont il a été bâti. Dans le corpus examiné par Moradi et Alizadeh Baygi, vingt-neuf portent sur les lettres isolées qui ouvrent certaines sourates, onze relient le nombre aux circonstances de la révélation, deux reposent sur le nombre attribué à chaque lettre et neuf relèvent de comptages divers (Moradi et Alizadeh Baygi 2023). Une dernière n’est pas numérique du tout. Le gros du dossier repose donc sur un seul type d’objet (les lettres isolées), et non sur une convergence de sources indépendantes.
Cette concentration compte, parce qu’elle change ce qu’un accumulation d’exemples peut établir. Cinquante-deux correspondances tirées de cinquante-deux endroits différents du texte impressionneraient davantage que vingt-neuf variations autour du même dispositif. Par ailleurs, les onze affirmations liées aux circonstances de la révélation dépendent d’informations extérieures au texte, dont l’exactitude devrait être établie séparément avant que le compte signifie quoi que ce soit.
La suite de l’évaluation confirme ce diagnostic avec des nombres. Dans ce même corpus, vingt-sept sont jugées arbitraires et dépourvues de généralité, avec l’emploi de plusieurs standards de calcul selon les cas (Moradi et Alizadeh Baygi 2023). Cinq autres ne tiennent qu’au prix de l’exclusion de certains versets du texte (Moradi et Alizadeh Baygi 2023). Douze dépendent d’affirmations secondaires étrangères au texte lui-même, et cinq n’ont, même exactes, rien qui sorte de l’ordinaire.
Voilà à quoi ressemble une méthode laissée ouverte pendant le comptage. Changer de standard selon le cas, retirer les versets qui gênent, faire dépendre un résultat d’éléments extérieurs au texte : chacun de ces gestes ajoute un degré de liberté, et aucun n’exige de commettre une faute de calcul. Un compte exact peut donc échouer à établir ce qu’on lui fait dire.
Le quatrième degré de liberté annoncé plus haut se voit ici à l’œil nu, en comparant deux auteurs. Khalifa ne retient qu’une seule des formules d’ouverture comme faisant partie du texte (Moradi et Alizadeh Baygi 2023; Khalifa 1982). Al-Faqih, lui, décide d’inclure les cent douze formules non numérotées, ainsi que les noms des cent quatorze sourates, en reconnaissant que le statut de ces noms fait débat et en argumentant pour les compter (Al-Faqih 2017).
Les périmètres de comptage sont donc une question à part. L’exactitude des opérations en est une autre. Al-Faqih note lui-même qu’aucune étude avant la sienne n’avait réuni ces trois ensembles (Al-Faqih 2017). La comparaison avec Khalifa repose ici sur l’évaluation de Moradi et Alizadeh Baygi, sans lecture directe de l’ouvrage de 1982. Elle ne permet pas de garantir que chacun des deux auteurs a correctement exécuté tous ses calculs.
Pour quiconque reçoit un chiffre sans son mode d’emploi, la conséquence est lourde. Deux résultats issus du même texte, obtenus par des auteurs également sérieux et poursuivant le même objectif, peuvent différer de plusieurs centaines d’unités sans qu’aucun calcul soit fautif nulle part. Un lecteur qui entend l’un des deux totaux, sans savoir que l’autre existe et sans connaître la frontière que chacun a tracée, reçoit donc une information dont la portée lui échappe, quelle que soit son attention.
La thèse de Khalifa a rencontré une opposition considérable de la part de savants et de commentateurs, dont les évaluateurs de 2023 nomment quatre représentants entre 1984 et 1996 : Hussein Naji Muhammad Mohyiddin, Muhammad Hassan Hito, Bassam Nihad Jarrar et Yazdani (Moradi et Alizadeh Baygi 2023; Khalifa 1982). Ce refus est venu d’un camp inattendu, et c’est ce qui le rend instructif pour un lecteur extérieur au débat.
Les opposants les plus nets sont en effet des partisans de l’idée générale d’une structure numérique. Bassam Nihad Jarrar publie en 1994 un texte intitulé Le miracle du nombre dix-neuf dans le saint Coran. Il y accuse Khalifa d’avoir fabriqué ses preuves (Moradi et Alizadeh Baygi 2023; Khalifa 1982). Vahedian, qui cherche lui aussi un ordre mathématique dans le texte, lui reproche d’avoir supprimé deux versets dans sa traduction pour faire tenir l’ordre annoncé (Moradi et Alizadeh Baygi 2023). L’affirmation a donc été refusée par ceux qui avaient le plus d’intérêt à l’accueillir favorablement.
Cette configuration se lit de deux manières. On peut y voir la preuve qu’un milieu savant sait refuser un argument qui l’arrangerait, ce qui est à son crédit. On peut aussi observer que ces opposants rejettent l’application du principe par cet auteur plutôt que le principe, et que d’autres travaux défendent la même idée générale sans le suivre (Moradi et Alizadeh Baygi 2023). Laquelle des deux lectures vous paraît la plus juste ? Un commentateur, Nasser Makarem Shirazi, s’est explicitement abstenu de trancher en 1993, jugeant qu’il fallait poursuivre les recherches (Moradi et Alizadeh Baygi 2023).
4. Ce qui tient dans le texte transmis
Un texte qui n’examinerait que ce qui s’effondre aurait choisi ses cibles, et il mériterait alors le reproche qu’il adresse aux autres. Des propriétés formelles du Coran se mesurent, elles sont établies, et personne ne les conteste. Les nommer laisse intact ce qui précède, et le lecteur a le droit de savoir où passe la ligne entre ce qui tient et ce qui ne tient pas.
La plus solide concerne la structure du texte transmis. Van Putten rapporte en 2019, en s’appuyant sur des travaux antérieurs de description des manuscrits, que ceux du type othmanien s’accordent sur l’ordre des sourates, sur l’ordre des versets à l’intérieur de chaque sourate et sur le contenu de ces versets (Putten 2019; Déroche 2014; Farrin 2020). La quasi-totalité des manuscrits coraniques connus relèvent de ce type, un palimpseste célèbre faisant exception, et les variations internes y demeurent mineures (Putten 2019; Déroche 2014; Farrin 2020).
Cette stabilité est une propriété formelle réelle, mesurable, et elle a été mesurée par des méthodes publiées. Elle ne dit rien sur l’origine du texte. Cette question demande d’autres compétences et d’autres sources. Elle ne valide pas davantage les comptes de mots examinés plus haut, puisque ceux-ci reposent sur des découpages et des périmètres qu’aucune stabilité du tracé ne vient fixer. Deux choses distinctes se ressemblent ici (l’accord des copies, et la manière de compter ce qu’elles portent), et les confondre est la faute la plus facile à commettre.
Savoir que deux manuscrits portent la même suite de consonnes ne dit rien de la manière dont il faudrait la découper en mots, ni de ce qu’il convient d’inclure dans le texte à compter. La stabilité porte sur ce qui est écrit ; les comptes portent sur ce qu’on décide d’en faire. Un accord parfait sur le premier laisse le second entièrement ouvert.
La manière dont cette stabilité a été établie compte autant que le résultat. Elle repose sur la comparaison de manuscrits datés, décrits et accessibles, dont les particularités partagées se constatent une à une, plutôt que sur une déclaration de principe (Putten 2019; Déroche 2014; Dutton 2004). Un tiers peut reprendre les mêmes documents et refaire le même examen (c’est la définition ordinaire d’un résultat). Voilà ce qui manque aux comptes de mots discutés plus haut. La différence est de nature.
L’analyse quantitative appliquée à un corpus a par ailleurs des usages sérieux, sans rapport avec la recherche de codes. Les questions d’attribution et de style se traitent avec des outils statistiques, dont le papier sur la douleur de quitter sa religion expose déjà la portée réelle et les limites. Ce qui distingue ces travaux des comptes discutés ici tient en un mot : leur méthode est fixée d’avance, publiée, et applicable par d’autres personnes à d’autres corpus.
Une structure numérique reste possible dans un texte quelconque, et la chercher est légitime. Une telle structure se démontrerait très bien, à condition d’annoncer d’avance la convention de comptage, le périmètre et le critère de réussite, puis de s’y tenir. Quelle convention fixeriez-vous avant d’ouvrir le livre ? Les évaluateurs de 2023 disent d’ailleurs la même chose, puisqu’ils commencent par définir les conditions d’une telle démonstration avant d’examiner si les affirmations les remplissent (Moradi et Alizadeh Baygi 2023).
5. Ce qu’un argument défait laisse en place
Montrer qu’un argument ne tient pas ne dit rien du texte sur lequel il porte, ni de ce que quiconque en croit. Un argument défectueux en faveur d’une thèse laisse cette thèse où elle était, et la charge revient alors aux autres arguments, s’il en existe.
Le raisonnement inverse serait tout aussi fautif, et il se rencontre tout autant. Celui qui conclurait de ce qui précède que le texte examiné ne vaut rien commettrait précisément le pas refusé depuis le début. Le papier sur les justifications sanitaires des prescriptions anciennes traite ce partage, en montrant qu’une justification fausse ne disqualifie pas la règle qu’elle prétendait fonder.
Le même examen s’applique aux comptages produits dans les autres traditions, et le refuser à l’une d’elles seulement viderait la démarche de son sens. La démonstration centrale s’est d’ailleurs appuyée sur un cas biblique, ce qui relève d’un choix plutôt que d’un hasard de documentation. La recherche de codes dans la Genèse a été publiée, discutée et réfutée dans une revue de statistique, et c’est ce dossier qui fournit ici le test le plus net (Witztum et al. 1994; Bar-Hillel et al. 1999).
Une remarque de Van Putten donne à ce parallèle une profondeur supplémentaire, et elle inverse une attente courante. Les traditions de lecture de la Bible hébraïque s’écartent du texte consonantique bien plus souvent que les lectures coraniques, avec des cas où un mot se récite sans être écrit, ou s’écrit sans être récité (Melchert 2000; Nasser 2020; Putten 2022a, 2022b, 2022c). Les deux corpus se comportent donc différemment, et la comparaison exige de la précision plutôt que des formules commodes.
Ce que le test de symétrie établit ici a des bornes. Il ne conclut pas que toutes ces recherches se valent dans le néant : il montre qu’une méthode capable de trouver son résultat dans n’importe quel texte long ne peut pas servir à distinguer un texte des autres. La conclusion porte sur l’instrument, et elle laisse entièrement ouverte la question de ce que chaque tradition affirme par ailleurs.
Les personnes qui répètent ces chiffres le font de bonne foi, et elles les tiennent de quelqu’un qui les avait reçus sans les vérifier, lui aussi. De qui tenez-vous le dernier chiffre que vous avez répété ? Une affirmation numérique a la solidité apparente d’un fait vérifiable, elle se transmet donc sans rencontrer de résistance, et c’est cette apparence qui accomplit tout le travail de conviction. La corriger demande de la patience plutôt que du courage (personne n’est attaqué) : celle de poser quatre questions dans l’ordre.
La même prudence vaut dans l’autre sens, envers ceux qui produisent ces travaux. Consacrer des années à dépouiller un texte pour en tirer des tableaux de fréquences est un labeur considérable, et le résultat de ce labeur garde sa valeur même s’il échoue à établir ce qu’il visait. Certes, l’argument tombe ; le sérieux du travail accompli, en revanche, reste entier, et le confondre avec la validité de sa conclusion serait une facilité.
6. Quelle règle de comptage, fixée quand ?
Devant une affirmation numérique, une seule question fait le travail, et elle se pose avant toute vérification. Quelle convention a été fixée avant de compter, et par qui ? Si la réponse existe et qu’elle est publique, le compte devient vérifiable et la discussion peut enfin commencer sur des bases communes. Si elle manque, aucun décompte ne tranchera, quel que soit le soin qu’on mette à le refaire.
Cette question se pose sans lire l’arabe, sans connaître les traditions de lecture et sans manier la statistique des tests multiples. Il suffit de demander quelle version du texte, quelle orthographe, quelle définition du mot et quel périmètre ont été retenus (dans cet ordre), puis de regarder lesquelles ont reçu une réponse, et à quel moment (fixée avant le comptage, ou exposée après).
Le lecteur peut refaire l’expérience seul, sur la prochaine affirmation de ce genre qu’il rencontrera. Poser les quatre questions prend une minute, et la conversation se déplace du chiffre vers la méthode, ce qui est le seul endroit où elle peut avancer. Ce déplacement ne convainc personne de changer d’avis, et il n’a d’ailleurs pas cette prétention.
Il produit autre chose, de plus modeste et de plus durable. Celui qui a compris pourquoi un total ne prouve rien tant que sa règle n’est pas écrite peut poser la même question aux chiffres frappants des débats publics (une portée supposée, non mesurée ici).
Un test simple permet de vérifier qu’on a bien saisi la distinction, et il tient en une comparaison. Si quelqu’un annonce qu’un mot revient trois cent soixante-cinq fois et qu’il publie en même temps sa convention de comptage, son périmètre et l’édition qu’il a dépouillée, alors son affirmation devient vérifiable et le désaccord éventuel portera sur des faits. Si ces informations manquent, aucun contradicteur ne pourra jamais démontrer que le chiffre est faux, et cette impossibilité même constitue le signal le plus utile qu’un lecteur puisse recevoir.
La question du titre a donc deux réponses, et elles se complètent. Ces comptes résistent au comptage en tant qu’arithmétique, parce qu’elle est vérifiable et qu’elle a été vérifiée ; ils n’y résistent pas en tant que preuve, parce qu’un texte long offre assez de comparaisons pour que quelque chose finisse par coïncider, et parce que la règle du comptage peut encore bouger quand le résultat est déjà connu. La première réponse rassure à tort, la seconde explique.
Une affirmation qu’aucune observation ne pourrait contredire ne décrit rien du monde : le papier sur la nostalgie pose la même exigence aux explications de la mémoire, qui ne valent que si elles interdisent quelque chose d’observable. Elle s’applique aux comptes de mots sans qu’on ait besoin de connaître le sujet en profondeur.
Il n’a été question que d’une manière de compter, et de ce qu’un compte peut établir lorsque la règle du jeu a été écrite avant la partie plutôt qu’après.